Si dices lo mismo que todos, no existes
Google, YouTube y los modelos de lenguaje llegaron a la misma regla sin copiarse: lo que ya has visto no cuenta. Y las tres facturas que pagas por separado son un solo problema.
- 1.
El ruido no ganó. Se acumuló
La mitad de lo que se publica ya lo escribe una máquina, pero el 86% de lo que rankea en Google lo escribió una persona. Se publica más que nunca y la visibilidad no se ha movido.
- 2.
Tres sistemas, la misma regla, sin copiarse
El paper de YouTube es de 2016, la patente de 2018, el anuncio de Google de 2024. Ahí no hay contagio posible: los tres están optimizados para la misma persona.
- 3.
Antes competías por estar. Ahora, por no sobrar
El filtro es viejo; lo que ha cambiado es el margen. Con la web llena, cualquier sistema puede descartar lo que se parece a otra cosa y seguir teniendo de sobra para responder.
Google, YouTube, ChatGPT. No se copiaron entre ellos. Llegaron al mismo sitio por separado. Y lo que decidieron los tres es lo mismo: lo que ya has visto no cuenta.
Por qué lo repetido dejó de contar
El ruido no ganó. Se acumuló
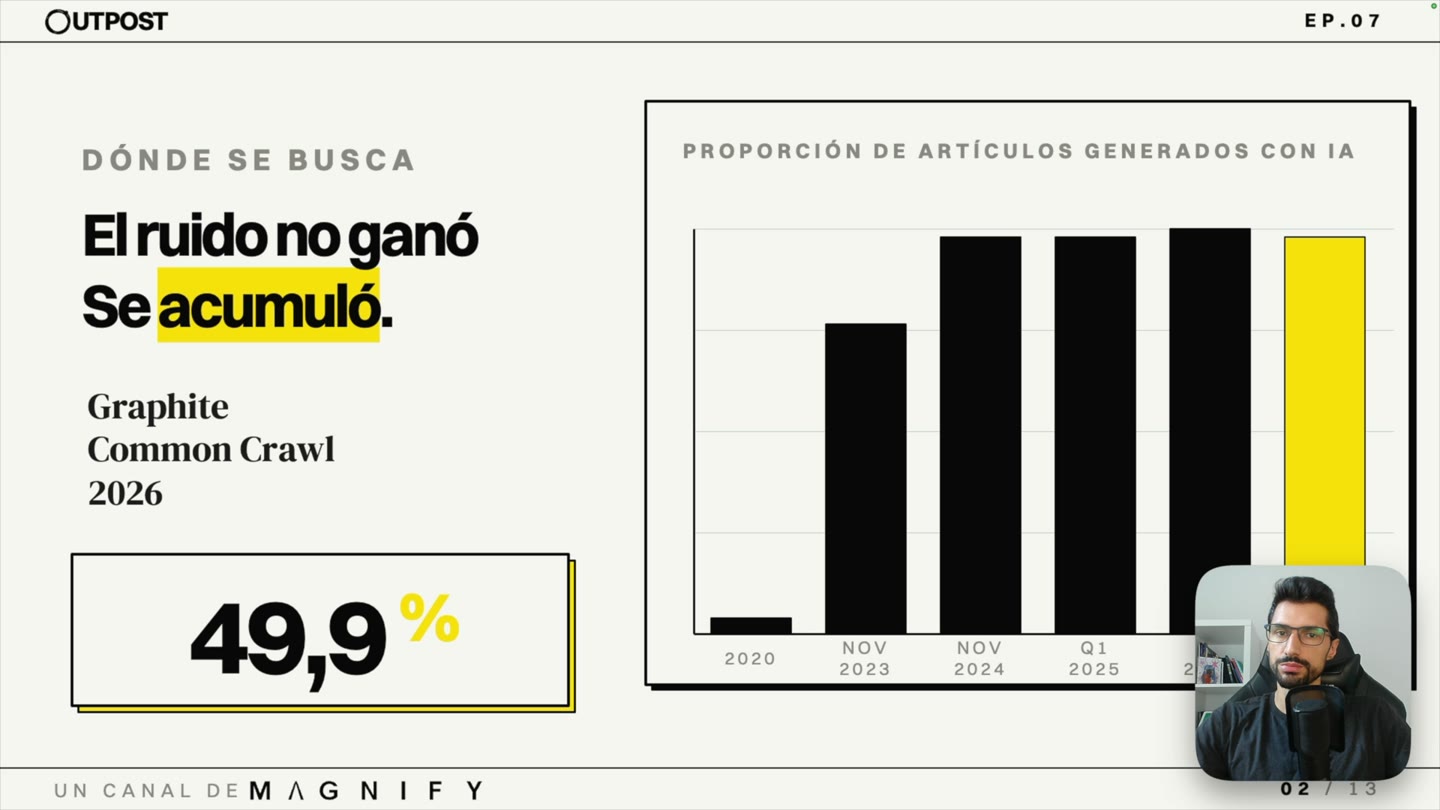
Desde 2023 se han publicado más de diez mil millones de páginas generadas con inteligencia artificial. La estimación es de Graphite, a partir de un muestreo de Common Crawl.
Ese dato lo has visto, y casi siempre viene con la misma conclusión detrás: la web se está llenando de ruido y pronto no quedará otra cosa.
Los datos de este año no dicen eso.
La proporción de artículos escritos mayoritariamente por una máquina lleva más de un año estancada. Alrededor del 50%. En el primer trimestre de 2026, 49,9%.
Y cuando miras lo que se ve, en vez de lo que se publica, la distancia es aún mayor. El 86% de lo que rankea en Google lo escribió una persona. El 82% de lo que citan ChatGPT y Perplexity, también.
Eso no dice lo que parece decir. El ruido no ganó. Se acumuló.
Se ha publicado más contenido que en ningún momento de la historia, y la visibilidad no se ha movido. Todo eso existe, y no lo ve nadie.
Ahrefs midió el suelo: catorce mil millones de páginas, el 96,55% sin tráfico de Google. Con un aviso que ellos mismos ponen: su muestra tiende al lado bueno de la web.
O sea que el número real es aún peor.
Filtro uno: lo que Google diseñó y lo que declaró
Ahora, los tres filtros. Y quiero que mires la fecha de cada uno.
En 2018 Google registra una patente que se concede en junio de 2022: Contextual estimation of link information gain. La firman Victor Carbune y Pedro Gonnet Anders.
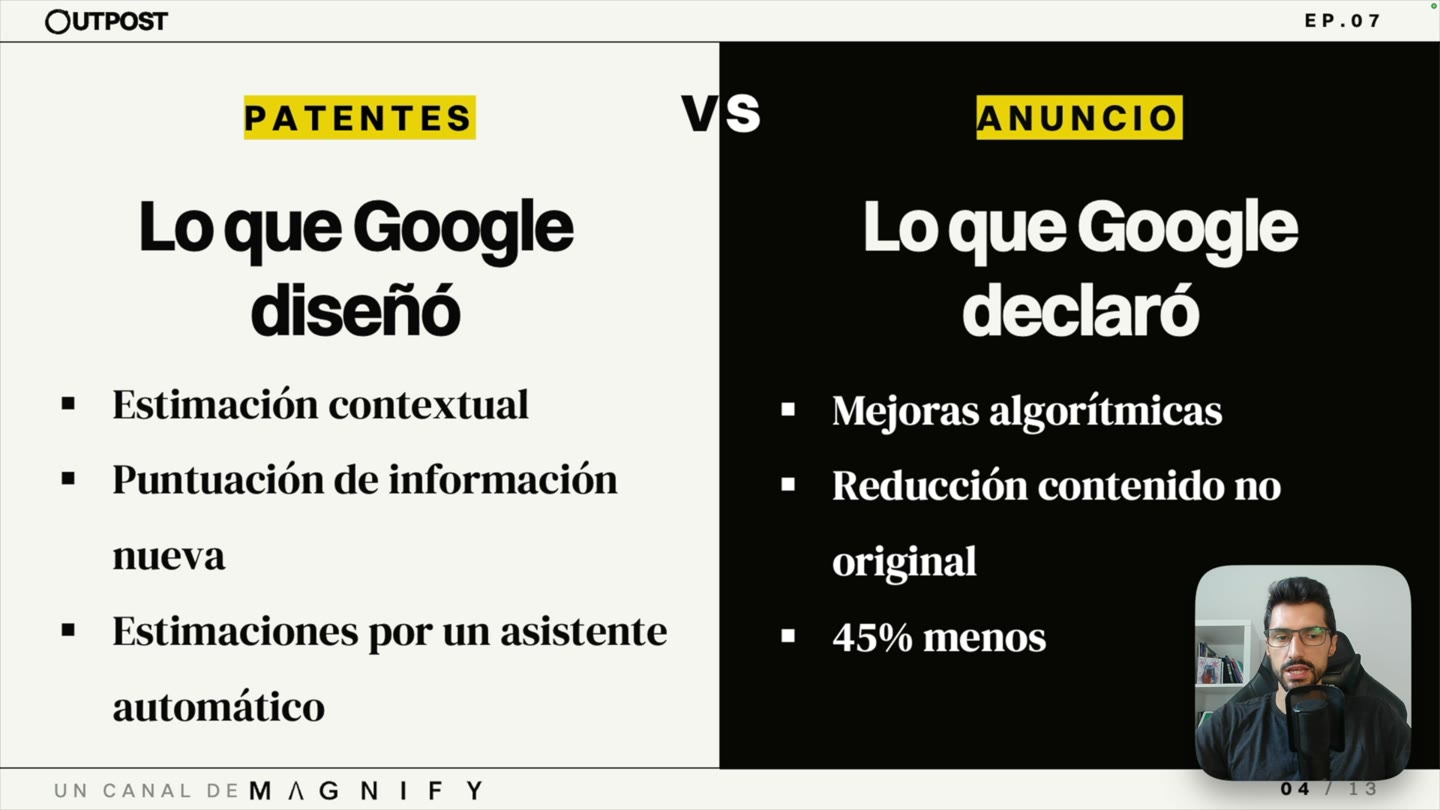
Lo que describe es un marcador. Puntúa cuánta información nueva aporta un documento respecto a los que ya se han mostrado.
Y aquí es donde el sector la cita mal, porque las reivindicaciones no hablan de ordenar la web. Hablan de un asistente automático que ya te ha enseñado unos documentos y tiene que elegir el siguiente. No es un factor de ranking confirmado. Es una patente, y Google patenta cosas que no llega a usar.
Lo que sí está declarado es otra cosa.
Marzo de 2024. Google anuncia un core update y lo anuncia con estas palabras: mejoras algorítmicas en los sistemas de ranking para reducir el contenido no original en los resultados de búsqueda. Cuando terminó el despliegue, la cifra que dieron fue 45% menos.
Una patente puede quedarse en un cajón. Un anuncio de producto, no.
Filtro dos: lo que YouTube optimiza de verdad
El segundo filtro es de YouTube, y allí no lo llaman así.
En 2016 Google publica el paper que describe su sistema de recomendación. Lo que optimiza el ranking no es el clic. Es el tiempo de visionado esperado por impresión.
Después la métrica objetivo se mueve dos veces más. De visualizaciones a tiempo de visionado. Y de tiempo de visionado a satisfacción.
Piensa qué es la satisfacción convertida en señal. Es la pregunta ¿te aportó algo? traducida a señal, medida a escala.
Un vídeo que repite lo que ya circula en su categoría no cae por calidad. Cae porque quien lo vio ya lo sabía.
Filtro tres: el 68% que no aparece
El tercero es el más reciente y el mejor medido.
Foundation y AirOps estudiaron 50 marcas B2B en 7 verticales. Cinco plataformas, sesenta días. 5,1 millones de respuestas y 57,2 millones de citaciones.
De todas esas citaciones, el 10,15% apunta al dominio propio de la marca.
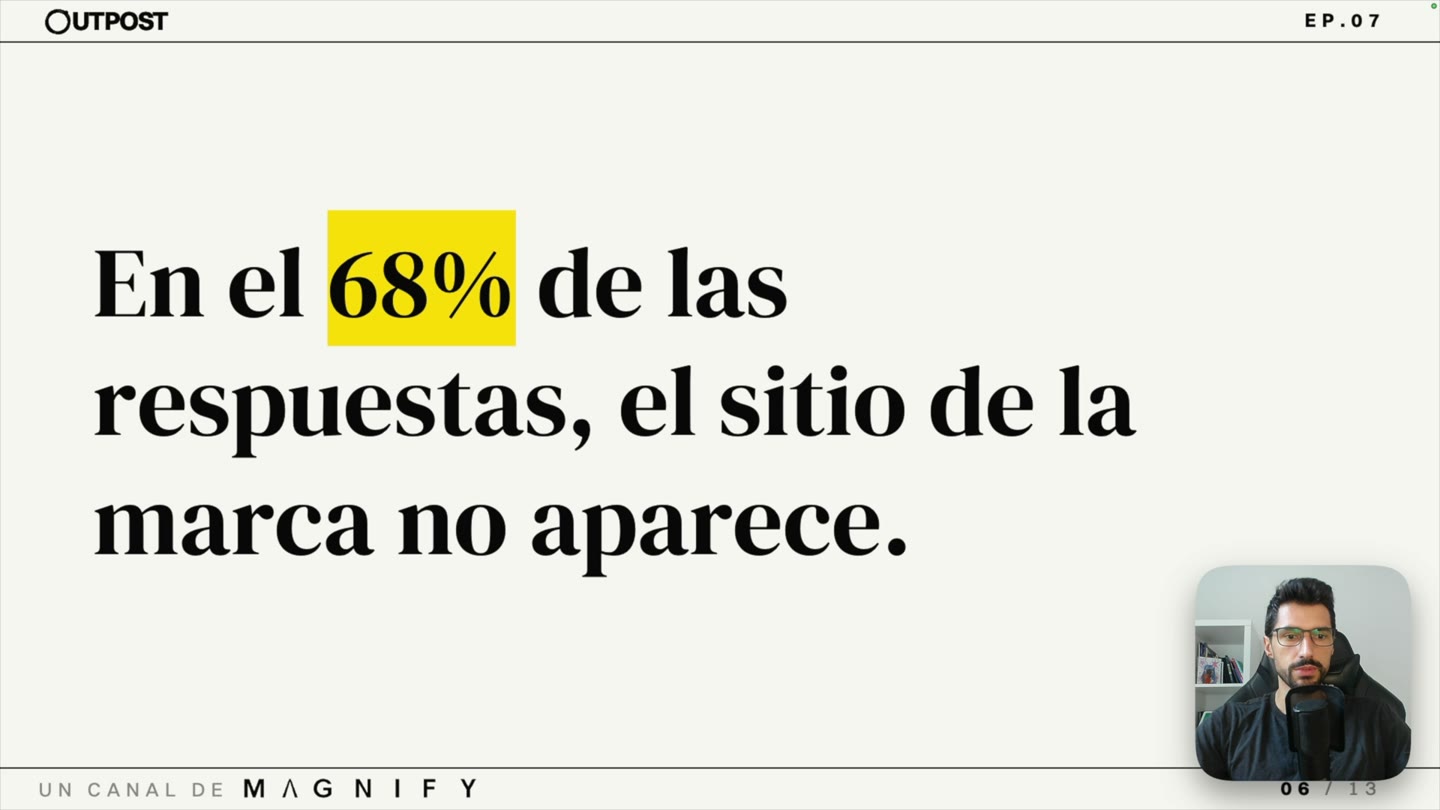
Pero la cifra es esta: en el 68% de las respuestas, el sitio de la marca no aparece en absoluto. Dos de cada tres veces que una IA le describe tu marca a un comprador, tu web no ha aportado nada. Es la otra cara de las tres capas sobre las que se sostiene tu ficha: la que corrobora no está hecha de páginas tuyas.
Y en las preguntas de categoría, las que forman la lista corta, las citaciones propias caen al 2,24%.
Ahrefs mide el mismo hueco desde otro lado. En febrero, el 38% de las páginas citadas en AI Overviews rankeaba también en el top 10 de Google. En julio del año pasado era el 76%.
Dos avisos sobre este dato, porque este episodio va precisamente de eso.
Uno: Ahrefs reconoce que parte de la caída viene de que ahora detectan mejor las citaciones, no solo de que Google haya cambiado. BrightEdge mide lo mismo y le sale 17%.
Dos: vas a encontrar la cifra contraria, que el 94% de los AI Overviews cita al menos un resultado orgánico del top. Las dos son verdad. Una mide presencia por respuesta, la otra mide reparto de citas. No es la misma pregunta.
El sector ya le ha puesto nombre a todo esto: bland tax, la tasa de lo insulso. Una tasa es algo que alguien te cobra. Y el precio es la visibilidad.
Tres facturas para un solo problema
Estos tres filtros se leen por separado. Y, sobre todo, se pagan por separado.
Hay alguien en tu equipo adaptándose al último core update. Hay otra persona intentando entender por qué el canal de YouTube no arranca. Hay una tercera, o una agencia que ha entrado este año, optimizando tu marca para inteligencia artificial.
Tres presupuestos. Tres calendarios. Y tres informes que llegan en semanas distintas y que no se citan entre ellos ni una sola vez.
Los tres problemas tienen la misma respuesta. Y eso que resuelven no está en ninguna de las tres plataformas.
Ocho años sin contagio posible
Repasemos las fechas.
2016, el paper de recomendación. 2018, la patente. 2024, el anuncio de Google. 2026, los datos de citación.
Ocho años, y equipos que no comparten roadmap, ni negocio, ni oficina, ni interés en que al otro le vaya bien. Google y OpenAI no se sientan a decidir juntos qué penalizan.
Ahí no hay contagio posible.
Me da la sensación de que el sector se equivoca de sujeto cuando lee esto. Buscamos qué hizo Google que copió OpenAI, y no hay nada que buscar.
Los tres sistemas están optimizados para la misma persona. La misma que abre Google por la mañana, ChatGPT a media tarde y YouTube en la cama.
No son tres audiencias. Es un cerebro con tres pestañas.
Y ese cerebro lleva toda la vida haciendo lo mismo. Cuando ya sabe algo, pasa de largo. No lo decide, simplemente pasa.
Nadie se copió. Los tres están escuchando a la misma persona.
El filtro es viejo. Lo industrializaron
Y esto no lo inventó nadie en 2024. Hay un momento en que lo dicen ellos con todas las letras.
En enero de 2019, YouTube publicó que la gente les estaba diciendo que recibía demasiadas recomendaciones parecidas, y que por eso pasaron a recomendar desde un abanico de temas más amplio.
El cambio no salió de un laboratorio. Salió de una queja. De la queja de un usuario. El ejemplo que pone el propio post es acabar viendo vídeos de galletas sin parar después de haber buscado una receta.
Y luego mira la curva de lo que han ido midiendo, que es la parte que a mí más me dice. De clics a visualizaciones. De visualizaciones a tiempo de visionado. De tiempo de visionado a satisfacción. De relevancia a información nueva.
No es un historial de cambios de algoritmo. Es una aproximación.
Primero, la señal más barata y la más fácil de engañar: el clic. Después, las visualizaciones: mejor, pero sigue sin decir si sirvió de algo. La tercera, el tiempo de visionado esperado por impresión. La cuarta, encuestas, likes, tiempo bien empleado. Y la quinta, cuánto aporta un documento frente a los ya vistos.
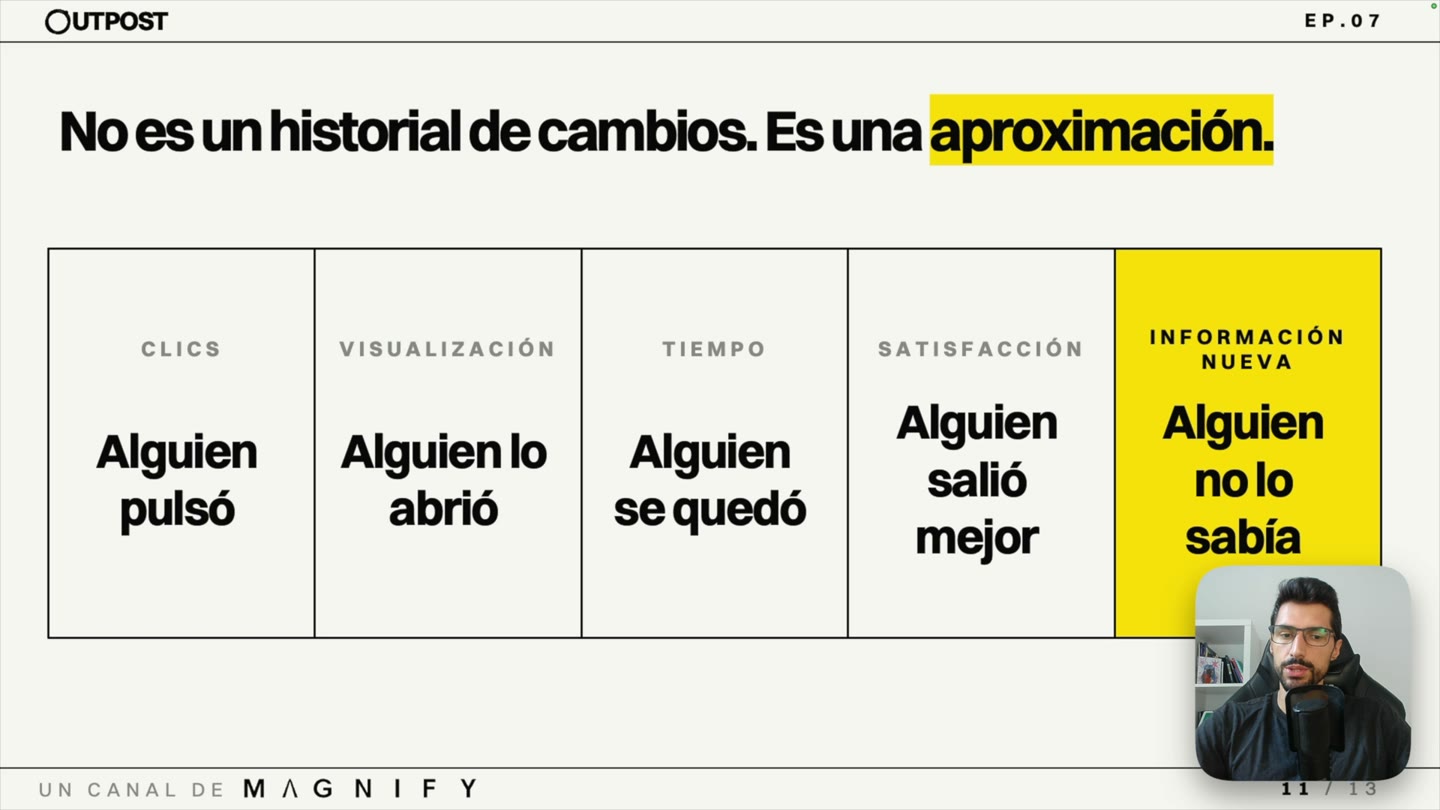
Son diez años de ingeniería acercándose despacio a medir algo que ya ocurría en la cabeza de tu cliente cuando el buscador todavía no existía.
Las máquinas no inventaron el filtro. Lo industrializaron.
Lo que sí cambió: el margen
Entonces, ¿por qué duele ahora y no en 2016?
El filtro es el mismo. Lo que se ha movido es el margen.
Durante veinte años, en casi cualquier tema había poco donde elegir. Publicabas la cuarta guía sobre algo y entrabas, porque solo había tres. Repetirse salía gratis. Repetirse era la estrategia: cubrir el tema, estar ahí, aparecer.
Con todo lo que se ha subido a la web desde 2023, ningún sistema tiene ya ese problema. Puede descartar cualquier cosa que se parezca a otra y seguir teniendo de sobra para responder.
Antes competías por estar. Ahora compites por no sobrar.
El test de sustitución
Y entonces, la pregunta: ¿qué haces el lunes?
No es decidir producir menos, ni decidir producir mejor, que no sé realmente qué significa. Si te estás planteando qué vas a producir el próximo trimestre, te dejo un test. Se aplica sobre el plan de contenidos del trimestre, no sobre la web entera. Son tres pasos.
Paso uno. Coge el plan y marca cada pieza que sostiene una afirmación que dejaría de estar sostenida si tu marca desapareciera mañana. Un dato que solo tú tienes. Una medición que solo tú has hecho. Una experiencia que solo tú has vivido.
Si no marcas ninguna, no tienes un plan de contenidos. Tienes un plan de cobertura. No es lo mismo, aunque cueste igual.
Paso dos. De lo que queda sin marcar, calcula cuánto podría producir un competidor con el mismo brief y una tarde. Ese porcentaje es tu exposición.
Y aquí está la prueba de todo lo anterior: haz el mismo test con tu canal de YouTube, o con tu LinkedIn. El resultado no cambia. Si cambiara, estaríamos hablando de tres problemas de plataforma. No cambia porque es uno.
Paso tres. Mira el presupuesto de contenido del trimestre y responde a una sola pregunta: qué porcentaje financia producción de información primaria.
No producción de piezas. Producción de información. Datos propios, mediciones propias, experiencia documentada, algo que no se pueda reproducir simplemente leyendo lo que ya existe.
Esa cifra es la decisión que sale de este episodio. Y en la mayoría de las empresas está cerca de cero, porque nadie la ha calculado nunca.
La unidad de reparto deja de ser el tema. Pasa a ser la afirmación que solo tú puedes firmar. La conversación sigue.
Preguntas frecuentes
-
¿Está la web llenándose de contenido generado con IA?
Se ha acumulado, pero no ha ganado. La proporción de artículos escritos mayoritariamente por una máquina lleva más de un año estancada alrededor del 50%, y en el primer trimestre de 2026 era del 49,9% según Graphite. Cuando miras lo que se ve en vez de lo que se publica, la distancia es mayor: el 86% de lo que rankea en Google lo escribió una persona, y el 82% de lo que citan ChatGPT y Perplexity, también.
-
¿Qué es el information gain de Google?
Es un marcador descrito en la patente «Contextual estimation of link information gain», solicitada en 2018 y concedida en junio de 2022, que puntúa cuánta información nueva aporta un documento respecto a los que ya se han mostrado. Conviene citarla con cuidado: sus reivindicaciones no hablan de ordenar la web, sino de un asistente automático que ya te ha enseñado documentos y elige el siguiente. No es un factor de ranking confirmado, y Google patenta cosas que no llega a usar.
-
Entonces, ¿qué sí ha declarado Google sobre el contenido no original?
El core update de marzo de 2024, anunciado con estas palabras: mejoras algorítmicas en los sistemas de ranking para reducir el contenido no original en los resultados de búsqueda. Cuando terminó el despliegue, la cifra que dio Google fue un 45% menos. Una patente puede quedarse en un cajón; un anuncio de producto, no.
-
¿Qué es el «bland tax»?
La tasa de lo insulso: el precio en visibilidad que pagas por decir lo mismo que ya dice tu categoría. El término es de Andrew Warden, director de marketing de Semrush, en el Adobe Summit, y lo recogió Danny Goodwin en Search Engine Land en abril de 2026. Una tasa es algo que alguien te cobra, y aquí el cobro es no aparecer.
-
¿Por qué mi web no aparece cuando una IA habla de mi marca?
Porque casi nunca hace falta. En el estudio de Foundation y AirOps sobre 50 marcas B2B, 57,2 millones de citaciones y 5,1 millones de respuestas, solo el 10,15% de las citaciones apunta al dominio propio de la marca, y en el 68% de las respuestas el sitio de la marca no aparece en absoluto. En las preguntas de categoría, las que forman la lista corta, las citaciones propias caen al 2,24%.
-
¿Se copiaron Google, YouTube y los modelos de lenguaje entre ellos?
No hay contagio posible. El paper de recomendación de YouTube es de 2016, la patente de 2018, el anuncio de Google de 2024 y los datos de citación de 2026: ocho años, y equipos que no comparten roadmap, ni negocio, ni interés en que al otro le vaya bien. Los tres sistemas están optimizados para la misma persona, la que abre Google por la mañana, ChatGPT a media tarde y YouTube en la cama. No son tres audiencias: es un cerebro con tres pestañas.
-
Si el filtro es viejo, ¿por qué duele ahora y no en 2016?
Porque lo que se ha movido es el margen, no el filtro. Durante veinte años, en casi cualquier tema había poco donde elegir: publicabas la cuarta guía sobre algo y entrabas, porque solo había tres. Con todo lo que se ha subido a la web desde 2023, ningún sistema tiene ya ese problema: puede descartar cualquier cosa que se parezca a otra y seguir teniendo de sobra para responder. Antes competías por estar; ahora compites por no sobrar.
-
¿Qué es el test de sustitución y cómo se aplica?
Son tres pasos sobre el plan de contenidos del trimestre, no sobre la web entera. Uno: marca cada pieza que sostiene una afirmación que dejaría de estar sostenida si tu marca desapareciera mañana. Dos: de lo que queda sin marcar, calcula cuánto podría producir un competidor con el mismo brief y una tarde, y ese porcentaje es tu exposición. Tres: mira qué porcentaje del presupuesto financia producción de información primaria, no de piezas. En la mayoría de las empresas esa cifra está cerca de cero porque nadie la ha calculado nunca.
FUENTES CITADAS EN EL EPISODIO
- Contextual estimation of link information gain · patente US11354342B2
- Core update de marzo de 2024 y nuevas políticas de spam
- Deep Neural Networks for YouTube Recommendations
- Continuing our work to improve recommendations on YouTube
- Proporción de artículos generados con IA y de contenido humano en resultados y citaciones
- Páginas sin tráfico de Google · 14.000 millones de páginas
- The Hidden Selection Phase · 57,2 millones de citaciones en 50 marcas B2B
- Citaciones en AI Overviews procedentes del top 10
- The hidden «bland tax» that could erase your brand from AI search